
Kesalahan prediksi machine learning bisa terjadi meskipun model sudah mempelajari banyak data. Model mungkin memberikan hasil yang benar pada sebagian besar kasus, tetapi tetap keliru ketika menghadapi data baru. Kondisi ini wajar karena Machine Learning mempelajari pola dari data, bukan memahami situasi seperti manusia. Karena itu, kita perlu memahami cara model belajar dan faktor apa saja yang dapat membuat hasil prediksinya meleset.
Bayangkan sebuah model yang bertugas membedakan email biasa dan spam. Selama proses training, model mempelajari ribuan contoh email dan mencari pola yang membedakan keduanya. Ketika model menerima email baru, model bisa saja menganggap pesan tersebut sebagai email biasa meskipun sebenarnya termasuk spam. Contoh sederhana ini menunjukkan bahwa model tidak selalu menghasilkan prediksi yang tepat.
Proses Machine Learning juga tidak berhenti setelah training selesai. Kita perlu menguji performa model, melihat jenis kesalahan yang muncul, lalu mencari penyebabnya. Dengan cara tersebut, kita dapat mengetahui apakah masalah muncul dari data, fitur, model, atau metode evaluasi yang kita gunakan.
Apa Penyebab Kesalahan Prediksi Machine Learning?
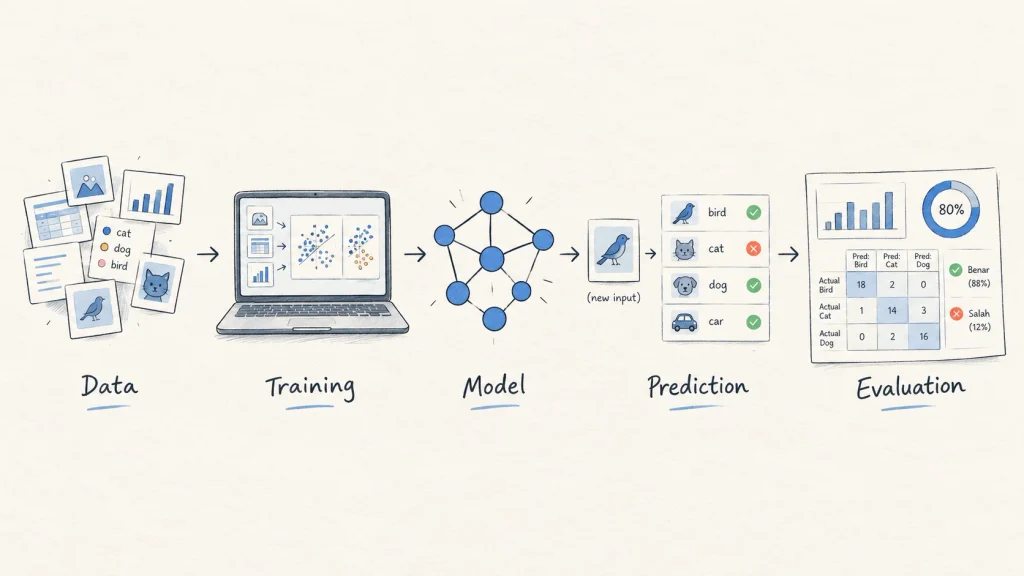
Model Machine Learning belajar berdasarkan contoh yang kita berikan. Selama proses training, algoritma mencari pola yang dapat membantu model membuat prediksi terhadap data baru. Model kemudian menggunakan pola tersebut ketika menerima data yang belum pernah ditemuinya. Jika data training memiliki masalah atau tidak cukup menggambarkan kondisi nyata, model dapat menghasilkan prediksi yang kurang tepat ketika menghadapi data baru.
Misalnya, kita membuat model untuk mengenali jenis kendaraan dari gambar. Jika sebagian besar gambar dalam dataset menampilkan mobil pada siang hari dengan pencahayaan yang jelas, model mungkin kesulitan mengenali mobil pada malam hari. Model tidak sengaja memberikan jawaban yang salah. Pola yang dipelajari model memang belum cukup untuk menghadapi kondisi yang berbeda.
Karena itu, kesalahan prediksi machine learning tidak selalu berasal dari algoritma. Kita perlu melihat seluruh proses, mulai dari pengumpulan data, pemilihan fitur, training, hingga evaluasi. Pendekatan tersebut membantu kita menemukan sumber masalah sebelum mengubah model atau mengganti algoritma.
Beberapa faktor utama perlu kita perhatikan ketika model menghasilkan prediksi yang keliru. Faktor tersebut mencakup kualitas data, pemilihan fitur, kompleksitas model, serta cara kita mengevaluasi hasilnya. Masing-masing faktor dapat memunculkan jenis masalah yang berbeda.
Data Training Memengaruhi Hasil Prediksi
Data training sangat memengaruhi performa model. Model hanya bisa mempelajari pola dari contoh yang tersedia di dalam dataset. Jika dataset terlalu sedikit atau hanya menggambarkan kondisi tertentu, model dapat kesulitan ketika menghadapi data dengan karakteristik berbeda.
Sebagai contoh, sebuah perusahaan ingin membuat model untuk memprediksi pelanggan yang berpotensi membeli produk. Tim data hanya mengumpulkan data pelanggan dari satu wilayah. Ketika perusahaan menggunakan model tersebut untuk pelanggan dari wilayah lain, model mungkin memberikan prediksi yang kurang akurat. Perbedaan karakteristik pelanggan dapat membuat pola yang dipelajari model kurang sesuai dengan kondisi baru.
Jumlah data memang penting, tetapi jumlah saja tidak menjamin kualitas model. Keragaman dan relevansi data juga memengaruhi kemampuan model dalam membuat prediksi. Dataset yang besar tetap dapat menghasilkan model yang kurang baik jika data tersebut tidak mewakili kondisi yang akan dihadapi model.
Karena itu, kita perlu memahami dataset sebelum memasukkannya ke proses training. Periksa karakteristik data, distribusi setiap kategori, dan kesesuaiannya dengan tujuan model. Langkah ini membantu kita menemukan masalah sejak awal dan mengurangi risiko model mempelajari pola yang terlalu sempit.
Baca Juga: Apa Itu Machine Learning? Yuk, Kenali Pengertian Sampai Cara Kerjanya
Data yang Tidak Bersih Bisa Membingungkan Model
Dataset jarang berada dalam kondisi sempurna. Kita bisa menemukan nilai yang tidak wajar, data duplikat, informasi yang tidak konsisten, atau label yang keliru. Jika kita langsung memasukkan data tersebut ke proses training, model dapat mempelajari pola yang keliru.
Misalnya, kita memiliki dataset untuk membedakan foto kucing dan anjing. Sebagian foto kucing ternyata memiliki label “anjing” karena seseorang salah memasukkan data. Model kemudian menganggap contoh tersebut sebagai bagian dari pola yang benar. Jika kesalahan label muncul dalam jumlah besar, kualitas prediksi model dapat ikut menurun.
Karena itu, proses data preprocessing memiliki peran penting dalam Machine Learning. Kita perlu memeriksa kualitas data sebelum menggunakannya untuk melatih model. Melalui proses tersebut, kita dapat memeriksa nilai yang bermasalah, data duplikat, konsistensi format, serta kualitas label.
Namun, kita juga perlu berhati-hati saat membersihkan data. Jangan langsung menghapus data hanya karena nilainya terlihat berbeda. Periksa konteksnya terlebih dahulu agar kita tidak membuang informasi yang sebenarnya penting bagi model.
Overfitting dan Underfitting Bisa Menyebabkan Kesalahan Prediksi
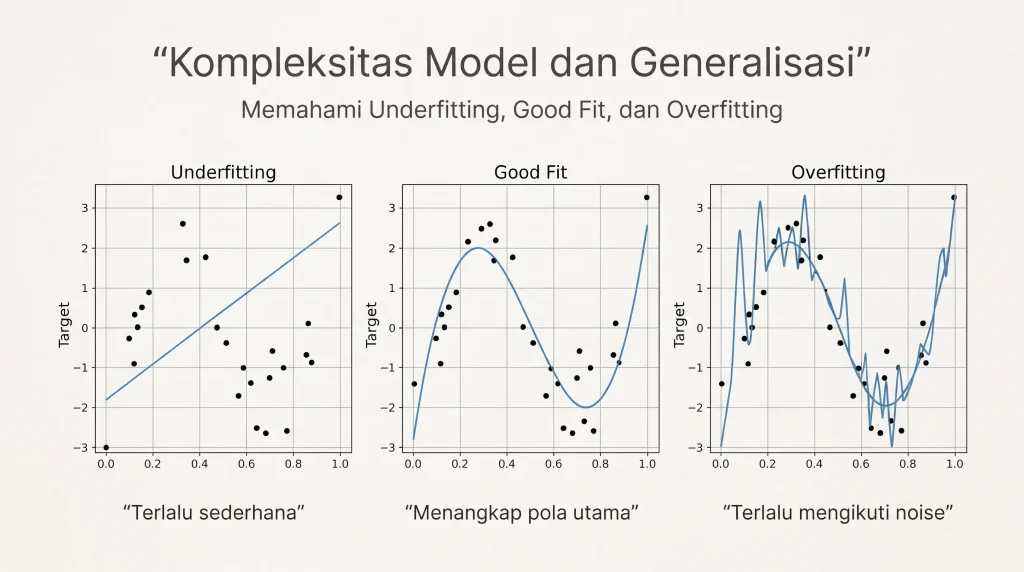
Selain kualitas data, cara model mempelajari pola juga dapat memengaruhi kesalahan prediksi machine learning. Dua kondisi yang sering muncul dalam proses ini adalah overfitting dan underfitting. Keduanya menunjukkan bahwa model belum menemukan tingkat kompleksitas yang sesuai dengan masalah.
Overfitting terjadi ketika model terlalu mengikuti data training. Model dapat menghasilkan performa yang sangat baik pada data yang sudah dikenalnya, tetapi performanya bisa menurun ketika menghadapi data baru. Model bahkan bisa menangkap noise atau pola khusus yang sebenarnya tidak membantu proses generalisasi.
Sebaliknya, underfitting terjadi ketika model terlalu sederhana untuk menangkap pola penting dalam data. Model kemudian menghasilkan performa yang kurang baik pada data training maupun data validasi. Kita dapat melihat kondisi tersebut dengan membandingkan performa model pada data training dan data validasi.
Dokumentasi resmi scikit-learn menjelaskan berbagai cara untuk mengevaluasi model, termasuk cross-validation. Dengan pendekatan ini, kita membagi data ke dalam beberapa bagian lalu menguji model pada bagian yang berbeda. Cara tersebut membantu kita melihat kemampuan model ketika menghadapi data di luar proses training.
Gambaran sederhananya seperti seseorang yang sedang belajar menghadapi ujian. Underfitting mirip dengan belajar terlalu sedikit sehingga orang tersebut belum memahami pola soal. Sementara itu, overfitting mirip dengan menghafalkan soal latihan sehingga orang tersebut kesulitan ketika menghadapi pertanyaan dengan bentuk berbeda. Model yang baik perlu menangkap pola penting tanpa terlalu bergantung pada contoh tertentu.
Pemilihan Fitur Juga Memengaruhi Prediksi
Model Machine Learning menggunakan fitur sebagai informasi untuk menghasilkan prediksi. Jika fitur yang kita pilih tidak relevan dengan target, model akan kesulitan menemukan pola yang berguna. Sebaliknya, terlalu banyak fitur yang tidak relevan dapat menambah noise dan membuat model mempelajari informasi yang tidak dibutuhkan.
Misalnya, kita ingin memprediksi apakah seseorang akan membeli sebuah produk. Riwayat pembelian, frekuensi kunjungan, atau interaksi dengan produk mungkin memberikan informasi yang lebih relevan daripada warna favorit seseorang. Namun, kita tetap perlu melihat karakteristik dataset dan tujuan prediksi sebelum menentukan fitur yang tepat.
Karena itu, jangan langsung memasukkan semua informasi yang tersedia ke dalam model. Pahami hubungan antara fitur dan target terlebih dahulu. Dengan cara tersebut, model dapat lebih fokus pada informasi yang memiliki hubungan dengan masalah yang ingin kita selesaikan.
Pemilihan fitur juga tidak selalu menghasilkan keputusan yang sama untuk setiap proyek. Fitur yang berguna pada satu model belum tentu memberikan manfaat yang sama pada model lain. Kita perlu menguji dan mengevaluasi fitur berdasarkan kebutuhan proyek.
Bagaimana Mengetahui Model Membuat Kesalahan?
Setelah proses training selesai, kita perlu menguji model dengan data baru. Pengujian tersebut membantu kita melihat kemampuan model saat menghadapi data yang belum masuk ke proses training. Dari sini, kita dapat melihat apakah model benar-benar mempelajari pola atau hanya bekerja baik pada data yang sudah dikenalnya.
Salah satu metrik yang sering digunakan dalam masalah klasifikasi adalah accuracy. Metrik ini menunjukkan proporsi prediksi yang benar dari seluruh prediksi. Dokumentasi resmi scikit-learn tentang accuracy score menyediakan fungsi accuracy_score untuk menghitung nilai accuracy pada hasil prediksi klasifikasi.
Namun, accuracy tidak selalu cukup untuk memahami kesalahan prediksi machine learning. Misalnya, sebuah dataset memiliki 1.000 transaksi dan hanya 10 transaksi yang termasuk penipuan. Model yang selalu memprediksi “bukan penipuan” tetap menghasilkan banyak prediksi benar karena sebagian besar transaksi memang bukan penipuan.
Masalah tersebut menunjukkan pentingnya melihat jenis kesalahan yang dibuat model. Dalam kasus klasifikasi, kita dapat menggunakan precision, recall, dan F1-score untuk melihat performa model dari beberapa sisi. Dokumentasi resmi scikit-learn menyediakan berbagai metrik evaluasi, termasuk precision, recall, F1-score, dan accuracy.
Baca Juga: AI Bisa Salah Jawab? Ternyata Ini Penyebabnya
Memahami Precision, Recall, dan F1-Score
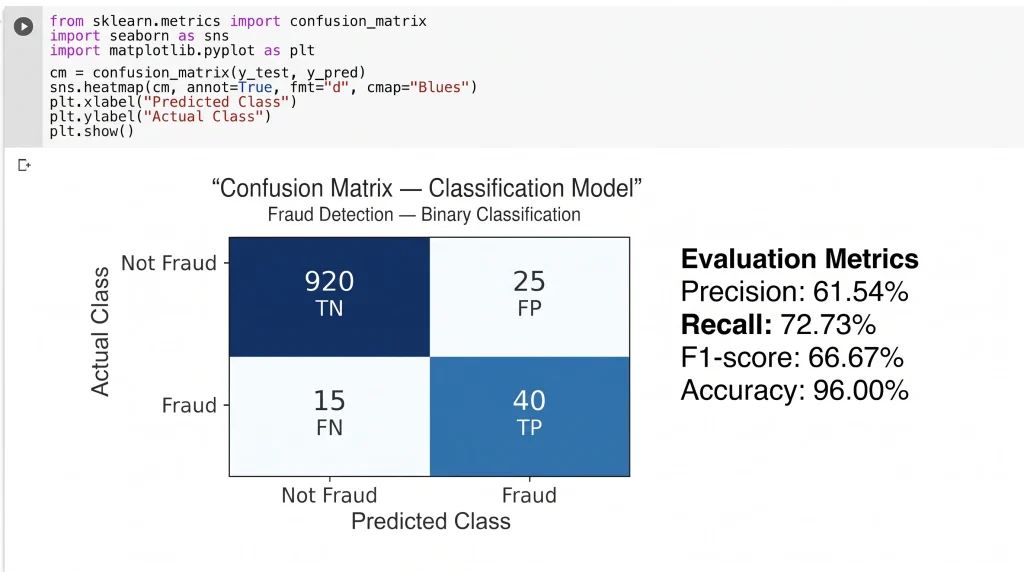
Precision membantu kita melihat seberapa banyak prediksi positif model yang benar-benar positif. Sementara itu, recall membantu kita melihat seberapa banyak kasus positif yang berhasil ditemukan model. Kedua metrik tersebut memberikan sudut pandang yang berbeda sehingga kita tidak hanya bergantung pada accuracy.
Bayangkan model yang bertugas mendeteksi transaksi penipuan. Precision membantu menjawab pertanyaan, “Dari semua transaksi yang model tandai sebagai penipuan, berapa banyak yang memang penipuan?” Sementara recall menjawab pertanyaan berbeda, yaitu, “Dari semua transaksi yang sebenarnya penipuan, berapa banyak yang berhasil ditemukan model?”
Perbedaan tersebut penting karena setiap jenis kesalahan dapat memiliki dampak yang berbeda. Dalam kasus tertentu, model yang terlalu sering melewatkan kasus positif dapat menimbulkan masalah yang lebih besar daripada model yang terlalu sering memberikan peringatan. Karena itu, kita perlu memilih metrik berdasarkan tujuan penggunaan model.
F1-score membantu kita melihat keseimbangan antara precision dan recall. Scikit-learn menjelaskan F1 sebagai harmonic mean dari kedua metrik tersebut. Kita dapat menggunakan F1-score ketika ingin melihat performa model dari sisi precision dan recall secara bersamaan.
Bagaimana Mengurangi Kesalahan Prediksi Machine Learning?
Ketika model menghasilkan banyak prediksi yang salah, jangan langsung mengganti algoritmanya. Cari tahu sumber masalah terlebih dahulu. Langkah ini membantu kita memilih solusi yang sesuai daripada mencoba berbagai algoritma tanpa memahami penyebabnya.
Jika masalah muncul dari kualitas data, periksa kembali dataset dan perbaiki masalah yang ditemukan. Jika model mengalami overfitting, evaluasi kompleksitas model dan uji performanya menggunakan data baru di luar proses training. Kita juga dapat menguji performa model dengan cross-validation pada beberapa pembagian data.
Kita juga perlu menjaga proses evaluasi agar tidak memberikan hasil yang terlalu optimistis. Jika kita menggunakan data yang sama untuk melatih dan mengevaluasi model, hasil evaluasi bisa terlihat lebih baik daripada performa model pada data baru. Karena itu, kita perlu memisahkan data sesuai kebutuhan dan memilih strategi validasi yang tepat.
Selain itu, pilih metrik berdasarkan tujuan model. Accuracy mungkin cukup untuk masalah tertentu, tetapi kasus lain dapat membutuhkan precision, recall, F1-score, atau metrik lain. Dokumentasi resmi scikit-learn menyediakan berbagai pilihan metrik dan strategi scoring yang dapat kita sesuaikan dengan karakteristik masalah.
Kesalahan Prediksi Machine Learning Tidak Selalu Berarti Model Buruk
Mempelajari kesalahan prediksi machine learning membantu kita memahami bahwa angka performa bukan satu-satunya pertimbangan. Model dengan accuracy tinggi belum tentu cocok untuk semua kebutuhan, terutama ketika dataset memiliki distribusi kelas yang tidak seimbang.
Model juga perlu bekerja dengan baik pada data baru. Jika model hanya memberikan performa tinggi pada data yang sudah dikenalnya, kita belum bisa langsung menyimpulkan bahwa model tersebut mampu melakukan generalisasi dengan baik.
Karena itu, proses Machine Learning tidak berhenti setelah kita membuat model. Kita perlu mengevaluasi data, melihat jenis kesalahan, menguji performa pada data baru, dan memperbaiki model jika hasilnya belum sesuai kebutuhan. Proses tersebut membantu kita memahami kemampuan model secara lebih realistis.
Pada akhirnya, model Machine Learning memang bisa salah prediksi. Hal terpenting bukan mencari model yang tidak pernah salah, melainkan memahami mengapa kesalahan terjadi, mengukur kesalahan dengan metode yang tepat, dan mengambil langkah perbaikan berdasarkan hasil evaluasi. Dengan pendekatan tersebut, kita tidak hanya mengejar angka performa yang tinggi, tetapi juga memastikan model mampu membantu menyelesaikan masalah yang sebenarnya.