
Train validation test data merupakan tiga bagian dataset yang membantu developer melatih, mengevaluasi, dan menguji model Machine Learning. Setiap bagian memiliki fungsi berbeda dalam proses pengembangan model. Dengan membagi dataset secara tepat, developer dapat menilai kemampuan model dalam mengenali pola dan membuat prediksi pada data baru. Model yang menghasilkan prediksi akurat pada data pelatihan belum tentu mampu memberikan hasil yang sama pada data yang belum pernah dipelajari. Karena itu, developer perlu memahami fungsi training data, validation data, dan test data sebelum membangun model.
Dalam praktiknya, pembagian dataset bukan sekadar membagi data menjadi beberapa kelompok. Developer juga perlu mempertimbangkan karakteristik data, tujuan proyek, dan metode evaluasi yang sesuai. Kesalahan dalam proses ini dapat membuat hasil pengujian terlihat lebih baik daripada kemampuan model yang sebenarnya. Dengan memahami fungsi setiap bagian dataset, Anda dapat menyusun proses pengembangan model secara lebih terarah dan menghindari kesalahan evaluasi yang umum terjadi.
Mengapa Train Validation Test Data Penting dalam Machine Learning?
Model Machine Learning mempelajari pola dari data untuk menghasilkan prediksi. Namun, model yang bekerja dengan baik pada data pelatihan belum tentu mampu menangani data baru. Salah satu penyebabnya adalah overfitting, yaitu kondisi ketika model terlalu menyesuaikan diri dengan pola dalam data pelatihan sehingga performanya menurun saat menghadapi data yang berbeda. Developer perlu menguji model dengan data di luar proses pelatihan untuk mengetahui kemampuannya melakukan generalisasi. Pembagian dataset membantu developer menjalankan evaluasi tersebut dengan lebih terstruktur.
Pembagian dataset juga membantu developer membandingkan beberapa model dan menentukan konfigurasi yang paling sesuai. Tanpa pemisahan yang jelas, developer berisiko memilih model hanya berdasarkan hasil pelatihan, bukan berdasarkan kemampuannya menghadapi data baru. Evaluasi yang kurang tepat juga dapat menyembunyikan kelemahan model, terutama jika data yang digunakan tidak mewakili kondisi nyata. Dengan membagi dataset sesuai fungsinya, developer dapat mengukur performa model secara lebih objektif dan membuat keputusan pengembangan berdasarkan hasil evaluasi yang relevan.
Baca Juga: Apa Itu Machine Learning? Pengertian dan Cara Kerjanya
Perbedaan Train Validation Test Data dan Fungsinya
Ketiga bagian dataset memiliki peran yang berbeda dalam proses pengembangan model. Training data membantu model mempelajari pola, validation data membantu developer memilih model dan menyesuaikan pengaturannya, sedangkan test data membantu mengukur performa akhir. Developer perlu menjaga pemisahan fungsi tersebut agar hasil evaluasi tetap dapat dipercaya. Berikut penjelasan mengenai fungsi masing-masing bagian dataset.
Training Data untuk Melatih Model
Training data merupakan bagian dataset yang digunakan developer untuk melatih model. Pada tahap ini, model mempelajari hubungan antara fitur dan target dari berbagai contoh dalam dataset. Dalam proyek prediksi harga rumah, misalnya, fitur dapat mencakup luas bangunan, luas tanah, jumlah kamar, dan lokasi, sedangkan targetnya berupa harga rumah. Model menggunakan contoh-contoh tersebut untuk mempelajari hubungan antara karakteristik rumah dan harga yang sesuai. Training data yang berkualitas dan beragam membantu model mengenali pola dengan lebih baik.
Jika data pelatihan tidak mewakili kondisi nyata, model mungkin kesulitan membuat prediksi yang akurat pada data baru. Misalnya, dataset yang hanya berisi rumah di kawasan perkotaan belum tentu cukup untuk membangun model yang mampu memprediksi harga rumah di wilayah pedesaan. Developer perlu memastikan bahwa data pelatihan mencerminkan variasi yang relevan dengan tujuan proyek. Ia juga perlu memeriksa data yang hilang, nilai yang tidak wajar, dan ketidakseimbangan sampel sebelum memulai pelatihan. Langkah-langkah tersebut membantu model mempelajari pola dari data yang lebih sesuai dengan kebutuhan prediksi.
Baca Juga: Memahami Supervised dan Unsupervised Learning: Apa Perbedaannya?
Validation Data untuk Memilih dan Menyesuaikan Model
Developer menggunakan validation data untuk mengevaluasi model selama proses pengembangan. Developer memanfaatkan hasil validasi untuk membandingkan algoritma, memilih hyperparameter, dan menentukan konfigurasi model yang paling sesuai. Hyperparameter merupakan pengaturan yang mengendalikan proses pembelajaran, bukan nilai yang dipelajari model secara langsung dari data. Contohnya meliputi kedalaman maksimum pada decision tree, jumlah tetangga pada K-Nearest Neighbors, dan nilai learning rate pada algoritma tertentu. Developer memeriksa hasil validasi untuk memilih konfigurasi yang sesuai dengan kebutuhan proyek.
Sebagai contoh, developer dapat membandingkan beberapa konfigurasi model untuk memprediksi harga rumah. Ia kemudian menggunakan validation data untuk menilai konfigurasi mana yang memberikan hasil terbaik berdasarkan metrik evaluasi yang dipilih. Namun, developer perlu berhati-hati ketika terlalu sering menyesuaikan model berdasarkan hasil validasi. Jika proses tersebut berlangsung berulang kali, model dapat terlalu menyesuaikan diri dengan karakteristik data validasi. Oleh karena itu, developer perlu menyimpan test data untuk mengukur performa akhir setelah proses pemilihan model selesai.
Test Data untuk Mengukur Performa Model
Test data membantu developer mengukur kemampuan model setelah proses pengembangan selesai. Developer harus menjaga test data tetap terpisah dari pelatihan dan pemilihan model agar keputusan pengembangan tidak memengaruhi evaluasi akhir. Developer sebaiknya menggunakan test data setelah memilih model, menentukan hyperparameter, dan menyelesaikan langkah pemrosesan data yang diperlukan. Hasil pengujian kemudian menunjukkan kemampuan model saat menghadapi data baru yang tidak terlibat dalam proses pengembangan. Dengan demikian, developer dapat memperkirakan performa model pada situasi penggunaan yang relevan.
Sebagai contoh, developer dapat menggunakan test data untuk menghitung Mean Absolute Error (MAE) pada model prediksi harga rumah. Metrik ini menunjukkan rata-rata selisih absolut antara hasil prediksi dan harga sebenarnya. Jika nilai MAE lebih rendah, prediksi model memiliki selisih rata-rata yang lebih kecil pada dataset pengujian tersebut. Namun, hasil ini tetap bergantung pada kualitas dan keterwakilan data yang digunakan. Developer juga perlu menghindari penggunaan test data secara berulang untuk memilih model karena kebiasaan tersebut dapat membuat hasil evaluasi akhir menjadi kurang independen.
Contoh Pembagian Train Validation Test Data
Bayangkan sebuah dataset berisi 1.000 catatan rumah yang akan digunakan untuk membangun model prediksi harga. Developer dapat membagi dataset tersebut menjadi tiga bagian, misalnya 70% untuk pelatihan, 15% untuk validasi, dan 15% untuk pengujian. Dengan rasio ini, developer memperoleh 700 catatan untuk training data, 150 untuk validation data, dan 150 untuk test data. Pembagian tersebut memberi setiap bagian dataset fungsi yang jelas selama proses pengembangan model. Namun, rasio ini hanya contoh dan tidak berlaku sebagai aturan universal untuk semua proyek Machine Learning.
| Bagian dataset | Jumlah data | Proporsi |
|---|---|---|
| Training data | 700 | 70% |
| Validation data | 150 | 15% |
| Test data | 150 | 15% |
| Total | 1.000 | 100% |
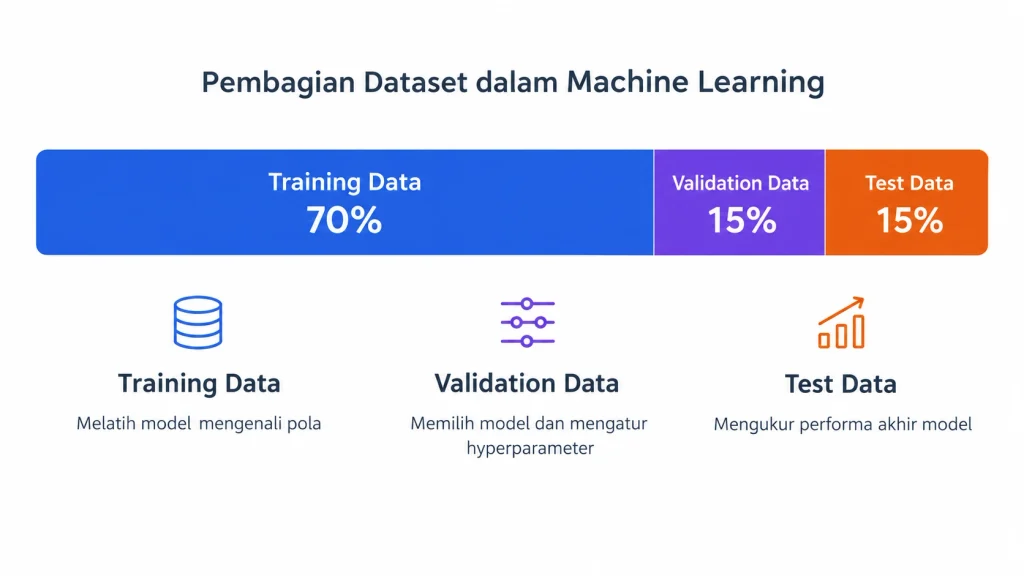
Sebelum memilih rasio pembagian, developer perlu menilai jumlah sampel, karakteristik dataset, kebutuhan validasi, dan tujuan evaluasi. Dataset yang berukuran kecil mungkin memerlukan pendekatan seperti cross-validation agar developer dapat memanfaatkan data secara lebih efisien. Sebaliknya, dataset yang sangat besar mungkin tidak membutuhkan proporsi validasi dan pengujian sebesar contoh tersebut. Pemilihan rasio train validation test data perlu mempertimbangkan kebutuhan proyek agar setiap bagian dataset menjalankan fungsinya dengan tepat. Developer juga perlu memastikan bahwa proses pembagian tidak menimbulkan kebocoran informasi antarbagiannya.
Cara Membagi Train Validation Test Data dengan Python
Python menyediakan pustaka scikit-learn yang memudahkan developer membagi dataset. Salah satu fungsi yang dapat digunakan adalah train_test_split, yang membagi data menjadi dua kelompok. Developer dapat membagi dataset dalam dua tahap untuk memperoleh training data, validation data, dan test data. Pertama, ia memisahkan 70% data untuk pelatihan dan menyisihkan 30% data sebagai kelompok sementara. Selanjutnya, ia membagi kelompok sementara menjadi dua bagian sama besar untuk validasi dan pengujian.
from sklearn.model_selection import train_test_split

# Pisahkan 70% data untuk pelatihan
# dan 30% data untuk validasi serta pengujian
X_train, X_temp, y_train, y_temp = train_test_split(
    X,
    y,
    test_size=0.30,
    random_state=42
)

# Bagi data sementara menjadi validation data dan test data
X_val, X_test, y_val, y_test = train_test_split(
    X_temp,
    y_temp,
    test_size=0.50,
    random_state=42
)

print("Jumlah training data:", len(X_train))
print("Jumlah validation data:", len(X_val))
print("Jumlah test data:", len(X_test))
Kode tersebut mengasumsikan bahwa variabel X berisi fitur dan y berisi target yang sesuai. Parameter test_size=0.30 menyisihkan 30% data pada pembagian pertama, sedangkan pembagian kedua membagi kelompok sementara menjadi dua bagian dengan proporsi yang sama. Hasil akhirnya mendekati rasio 70:15:15 jika jumlah sampel memungkinkan pembagian tersebut. Parameter random_state=42 membantu menghasilkan pembagian acak yang konsisten ketika Anda menjalankan kode dengan dataset dan lingkungan yang sama. Sebelum menjalankan contoh ini, siapkan variabel X untuk fitur dan y untuk target.
Namun, pembagian acak tidak selalu sesuai untuk semua jenis dataset. Developer perlu mempertimbangkan distribusi kelas, urutan waktu, dan hubungan antardata sebelum menentukan metode pembagian. Untuk klasifikasi dengan kelas yang tidak seimbang, parameter stratify dapat membantu mempertahankan proporsi kelas pada setiap bagian data. Sementara itu, data deret waktu memerlukan pembagian yang mempertahankan urutan waktu agar model tidak menggunakan informasi masa depan saat memprediksi masa lalu. Pemilihan strategi yang tepat membantu menghasilkan evaluasi yang lebih mendekati kondisi penggunaan sebenarnya.
Hal yang Perlu Diperhatikan dalam Pembagian Train Validation Test Data
Pembagian dataset tidak cukup hanya dengan menentukan persentase. Developer juga perlu memperhatikan karakteristik data, tujuan evaluasi, dan kemungkinan munculnya kebocoran informasi. Strategi yang sesuai untuk data gambar, misalnya, belum tentu tepat untuk data transaksi yang memiliki urutan waktu. Begitu pula dataset dengan kelas yang tidak seimbang memerlukan perhatian khusus agar setiap bagian tetap mewakili karakteristik data yang relevan. Beberapa hal berikut perlu diperhatikan sebelum developer melatih dan mengevaluasi model.
Mengatasi Ketidakseimbangan Kelas dalam Dataset
Pada masalah klasifikasi, jumlah contoh untuk setiap kelas dapat berbeda jauh. Misalnya, dataset deteksi penipuan mungkin memiliki jauh lebih banyak transaksi normal daripada transaksi penipuan. Pembagian acak biasa dapat menghasilkan proporsi kelas yang berbeda antara training data dan data evaluasi, terutama jika jumlah sampel relatif sedikit. Untuk kasus yang sesuai, developer dapat menggunakan parameter stratify pada train_test_split agar setiap bagian mempertahankan proporsi kelas sedekat mungkin dengan dataset awal. Strategi ini membantu evaluasi menjadi lebih representatif, meskipun developer tetap perlu memeriksa jumlah sampel untuk setiap kelas.
X_train, X_temp, y_train, y_temp = train_test_split(
    X,
    y,
    test_size=0.30,
    random_state=42,
    stratify=y
)
Contoh tersebut menerapkan stratifikasi saat membagi data untuk pelatihan dan kelompok sementara. Jika developer ingin mempertahankan proporsi kelas pada pembagian kedua, ia juga perlu menerapkan stratifikasi yang sesuai pada kelompok sementara, selama jumlah sampel tiap kelas memungkinkan. Developer perlu berhati-hati jika terdapat kelas dengan jumlah contoh yang sangat sedikit karena stratifikasi tidak dapat mengatasi keterbatasan jumlah sampel. Untuk kasus seperti itu, ia mungkin perlu meninjau kembali strategi evaluasi atau mengumpulkan data tambahan.
Membagi Train Validation Test Data untuk Time Series
Data deret waktu atau time series memiliki urutan yang penting. Contohnya meliputi data penjualan bulanan, harga saham, dan jumlah kunjungan harian. Pada kasus tersebut, pembagian acak dapat membuat model mempelajari informasi dari masa depan ketika tugas sebenarnya adalah memprediksi kejadian pada masa berikutnya. Kondisi tersebut menghasilkan evaluasi yang tidak mencerminkan penggunaan model di dunia nyata. Developer sebaiknya menggunakan periode terdahulu untuk pelatihan, lalu memakai periode berikutnya untuk validasi dan pengujian.
Sebagai contoh, developer dapat melatih model menggunakan data penjualan Januari hingga September, memakai data Oktober dan November untuk validasi, lalu menggunakan data Desember untuk pengujian. Pembagian tersebut mempertahankan urutan waktu sehingga developer dapat menilai kemampuan model memprediksi periode berikutnya. Developer tetap perlu mempertimbangkan pola musiman, perubahan tren, dan jumlah data yang tersedia. Jika proyek memerlukan evaluasi berulang pada beberapa periode, ia dapat mempertimbangkan metode validasi khusus deret waktu. Dengan begitu, proses evaluasi dapat mengikuti karakteristik data tanpa mencampurkan informasi masa depan ke dalam proses pelatihan.
Mencegah Data Leakage saat Membagi Dataset
Data leakage terjadi ketika informasi yang seharusnya tidak tersedia selama pelatihan masuk ke proses pengembangan model. Kebocoran ini dapat membuat hasil evaluasi terlihat lebih baik daripada kemampuan model yang sebenarnya. Salah satu contohnya adalah ketika developer menghitung nilai rata-rata dan standar deviasi dari seluruh dataset sebelum melakukan pembagian. Langkah tersebut membuat informasi dari validation data dan test data ikut memengaruhi proses transformasi. Akibatnya, hasil evaluasi tidak lagi menggambarkan kemampuan model secara akurat saat menghadapi data baru.
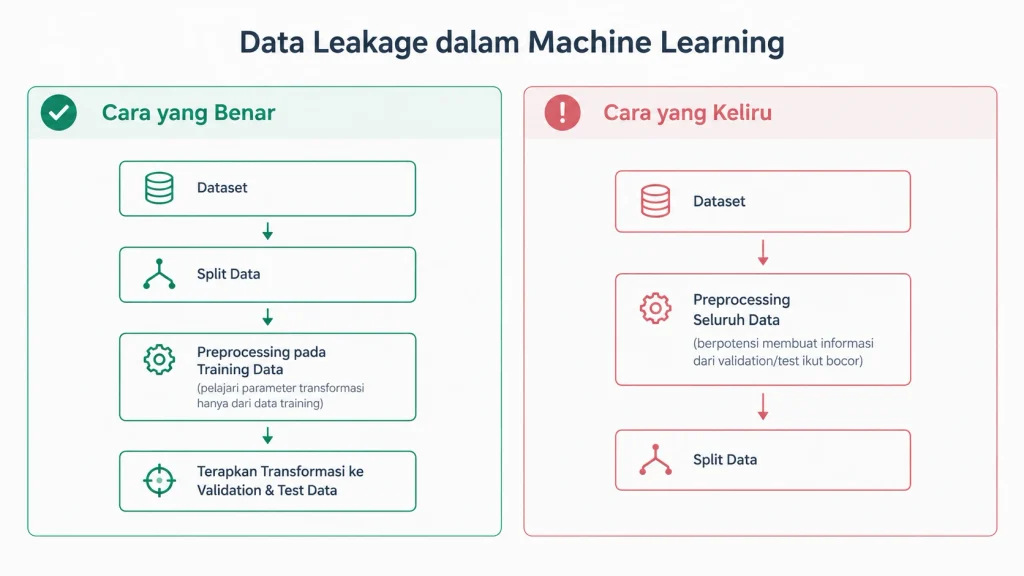
Developer dapat mencegah masalah ini dengan membagi dataset sebelum melakukan prapemrosesan. Setelah itu, developer melatih proses transformasi menggunakan training data, lalu menerapkan transformasi yang sama pada data validasi dan pengujian. Dokumentasi resmi scikit-learn membahas masalah tersebut dalam bagian Common pitfalls and recommended practices. Developer juga dapat menggunakan pipeline untuk menggabungkan langkah prapemrosesan dan pelatihan model sehingga alur pemrosesan lebih konsisten. Pendekatan tersebut membantu mengurangi risiko kebocoran data selama evaluasi.
Menggunakan Cross-Validation untuk Mengevaluasi Model
Cross-validation merupakan teknik evaluasi yang membagi data menjadi beberapa bagian atau fold. Developer melatih model dengan sebagian fold, lalu mengevaluasi performanya menggunakan fold yang tersisa. Proses ini berulang dengan pergantian bagian evaluasi sehingga setiap fold mendapat giliran untuk menjadi data validasi. Dengan teknik tersebut, developer dapat menilai kestabilan performa model, terutama ketika jumlah data terbatas.Penjelasan lebih lanjut tersedia pada dokumentasi resmi Cross-validation: evaluating estimator performance.
Meskipun demikian, cross-validation tidak otomatis menggantikan test data independen untuk evaluasi akhir. Jika proyek memerlukan pengujian akhir yang terpisah, developer dapat menyisihkan test data terlebih dahulu. Ia kemudian menjalankan cross-validation pada bagian data pengembangan untuk memilih model dan hyperparameter. Setelah proses pemilihan selesai, developer dapat melatih model sesuai strategi yang dipilih dan mengevaluasinya pada test data. Langkah ini membantu menjaga pemisahan antara proses pemilihan model dan pengukuran performa akhir.
Kesalahan Umum dalam Pembagian Dataset
Beberapa kesalahan dalam pengelolaan dataset dapat mengurangi keandalan evaluasi model. Kesalahan tersebut tidak selalu muncul dari algoritma yang digunakan, tetapi juga dapat berasal dari cara developer menyiapkan dan memisahkan data. Karena itu, developer perlu memeriksa alur kerja secara menyeluruh, bukan hanya melihat skor akhir model. Berikut beberapa kesalahan yang perlu dihindari selama proses pengembangan.
- Menggunakan test data berulang kali untuk memilih model. Kebiasaan ini membuat keputusan pengembangan ikut menyesuaikan diri dengan hasil pengujian sehingga skor akhir kehilangan sebagian independensinya.
- Melakukan prapemrosesan sebelum membagi dataset. Jika proses transformasi mempelajari informasi dari seluruh dataset, developer dapat menimbulkan data leakage.
- Mengabaikan distribusi data. Jika memilih strategi pembagian yang tidak sesuai, developer dapat memperoleh data evaluasi yang kurang mewakili kondisi sebenarnya.
- Memilih rasio pembagian tanpa mempertimbangkan konteks. Tidak semua proyek cocok menggunakan rasio 70:15:15 atau rasio populer lainnya.
- Mengabaikan hubungan antardata. Data dari orang, perangkat, lokasi, atau kelompok yang sama mungkin perlu tetap berada dalam bagian dataset yang sama agar evaluasi tidak terlalu optimistis.
Dengan menghindari kesalahan tersebut, developer dapat memperoleh gambaran performa model yang lebih masuk akal. Ia juga dapat mengurangi risiko mengambil keputusan berdasarkan hasil evaluasi yang menyesatkan. Jika struktur dataset memiliki karakteristik khusus, developer sebaiknya menyesuaikan strategi pembagian sebelum memulai pelatihan. Langkah tersebut membantu proses pengembangan berjalan lebih konsisten dan menghasilkan evaluasi yang lebih dapat dipercaya.
Memahami Pembagian Dataset untuk Evaluasi Model yang Lebih Baik
Train validation test data memiliki tiga fungsi utama dalam pengembangan Machine Learning. Training data membantu model mempelajari pola, validation data mendukung pemilihan model dan hyperparameter, sedangkan test data mengukur performa akhir pada data yang tidak terlibat dalam proses pengembangan. Developer perlu menyesuaikan strategi pembagian dengan ukuran dataset, distribusi kelas, urutan waktu, dan hubungan antardata. Ia juga perlu mencegah data leakage agar hasil evaluasi tidak memberikan gambaran yang terlalu optimistis. Dengan memisahkan dataset secara tepat, developer dapat menilai kemampuan model dan mengambil keputusan berdasarkan hasil evaluasi yang lebih andal.